
Retargeting de recherche Amazon Bedrock : le cas Yahoo

Un pipeline d'expansion de mots-clés vieux de plusieurs années, construit sur Word2Vec et une technique de hachage approximatif (LSH, Locality-Sensitive Hashing), finit toujours par montrer ses limites. C'est ce constat qui a poussé les équipes de Yahoo à reconstruire leur système de retargeting de recherche autour d'un LLM hébergé sur Amazon Bedrock. Le billet technique publié par AWS le 18 juin 2026 détaille l'architecture, la méthode d'évaluation et surtout le mécanisme qui empêche les hallucinations du modèle de dégrader le ciblage publicitaire.
Le problème : l'expansion de mots-clés à l'ancienne montrait ses limites
Ce que faisait le pipeline Word2Vec + LSH chez Yahoo
Le retargeting de recherche consiste à élargir une requête utilisateur en un ensemble de mots-clés apparentés, pour toucher un public plus large sans perdre la pertinence. Chez Yahoo, ce travail reposait sur des vecteurs Word2Vec entraînés sur un corpus historique de requêtes, associés à un index LSH pour retrouver rapidement les termes les plus proches dans cet espace vectoriel.
Cette approche a fonctionné longtemps parce qu'elle est rapide et peu coûteuse en calcul. Mais elle capture une proximité statistique de cooccurrence, pas une compréhension du sens.
Quatre limites concrètes : vocabulaire périmé, similarité syntaxique, expansion nulle
Le vocabulaire du modèle Word2Vec vieillit : les nouvelles marques, produits ou expressions n'apparaissent qu'après un nouveau cycle d'entraînement complet.
La similarité captée est souvent syntaxique plutôt que sémantique : deux termes proches dans l'espace vectoriel peuvent partager un contexte d'usage sans partager d'intention d'achat.
Pour les requêtes rares ou de longue traîne, l'index LSH ne trouve parfois aucun voisin suffisamment proche, et l'expansion retourne un ensemble vide.
Le système ne raisonne pas sur l'intention derrière une requête : il ne distingue pas une recherche informative d'une recherche transactionnelle.
La solution : expansion de mots-clés par LLM via Amazon Bedrock
Pourquoi Bedrock : accès serverless à plusieurs modèles de fondation
Amazon Bedrock est un service managé qui expose, via une API unique, plusieurs modèles de fondation de fournisseurs différents (Anthropic, Meta, Amazon, entre autres), sans que l'équipe applicative n'ait à gérer l'infrastructure GPU sous-jacente. C'est ce qui a permis à Yahoo de tester plusieurs modèles côte à côte pour la même tâche d'expansion, sans multiplier les intégrations techniques.
Le choix de Claude 3.5 Sonnet v2 et la méthode d'évaluation
Après une phase de comparaison entre modèles disponibles sur Bedrock, Yahoo a retenu Claude 3.5 Sonnet v2 d'Anthropic pour la tâche de génération de mots-clés candidats, selon le billet AWS du 18 juin 2026. Le modèle reçoit la requête d'origine et un prompt structuré qui lui demande de proposer des variantes sémantiquement proches, avec des contraintes de format pour faciliter le traitement en aval.
Le point important : le LLM ne remplace pas l'ensemble du pipeline, il en devient le premier maillon générateur. La sortie du modèle n'est jamais injectée directement dans les campagnes publicitaires.
Le garde-fou qui fait la différence : vérification par vecteurs sémantiques
Comment le scoring de similarité filtre les hallucinations
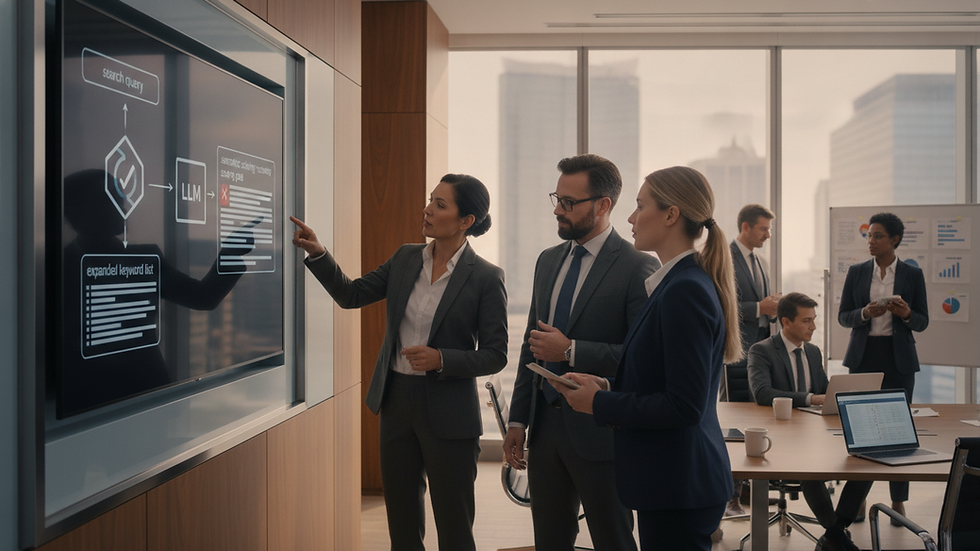
C'est l'élément central de l'architecture, et celui qui mérite le plus d'attention pour qui veut s'en inspirer. Chaque mot-clé généré par Claude 3.5 Sonnet v2 est repassé dans un modèle d'embedding pour produire un vecteur sémantique, comparé ensuite à celui de la requête d'origine via un score de similarité cosinus. Les candidats dont le score tombe sous un seuil défini sont écartés avant d'atteindre le système de diffusion publicitaire.
Ce mécanisme traite un problème connu des LLM en production : la génération de termes plausibles mais faux ou hors sujet, communément appelée hallucination. Un modèle de langage peut proposer un mot-clé grammaticalement correct et lexicalement voisin, mais sémantiquement éloigné de l'intention de recherche initiale. Le filtre vectoriel agit comme une seconde opinion indépendante du modèle génératif.
Filtrage des termes sensibles, denylists et conformité
En complément du scoring sémantique, le pipeline applique des listes d'exclusion (denylists) pour écarter les termes sensibles, les marques concurrentes ou les catégories interdites en publicité programmatique. Cette couche de filtrage par règles reste nécessaire : un score de similarité élevé ne garantit pas la conformité réglementaire ou contractuelle d'un terme.
Les gains chiffrés et ce qu'ils veulent vraiment dire
Ratio d'expansion médian multiplié par 5
Selon le benchmark interne publié par Yahoo et AWS le 18 juin 2026, le ratio d'expansion médian de mots-clés par requête a été multiplié par environ 5 avec la nouvelle architecture, comparé au pipeline Word2Vec+LSH. Ce chiffre provient d'une mesure interne à Yahoo, pas d'un audit tiers indépendant : il faut le lire comme un ordre de grandeur communiqué par l'entreprise elle-même, dans le cadre d'un billet coécrit avec son fournisseur cloud.
Des centaines de mots-clés là où LSH en produisait zéro
Le gain le plus parlant concerne les requêtes de longue traîne. Là où l'ancien pipeline retournait un ensemble vide faute de voisin suffisamment proche dans l'index LSH, l'approche par LLM génère plusieurs centaines de mots-clés candidats avant filtrage sémantique. C'est sur ce segment, historiquement mal couvert, que la bascule vers un LLM change concrètement la couverture du ciblage.
Ce résultat ne dit rien, en revanche, du taux de conversion final des campagnes ni du coût par acquisition. Le billet AWS documente une amélioration du pipeline d'expansion, pas une mesure de performance publicitaire de bout en bout.
Ce que ce cas ne dit pas : les limites
Le billet AWS ne communique aucun chiffre de coût d'inférence à l'échelle de Yahoo, ni de latence bout en bout pour le pipeline complet. Générer des mots-clés via un LLM coûte structurellement plus cher, par requête, qu'une recherche dans un index vectoriel préconstruit type Word2Vec+LSH : c'est un arbitrage volume contre qualité que chaque organisation doit chiffrer avec son propre trafic.
Le mécanisme de vérification sémantique réduit le risque d'hallucination, il ne l'élimine pas. Un score de similarité élevé peut valider un terme sémantiquement proche mais commercialement inadapté (une marque concurrente proche thématiquement, par exemple), d'où la nécessité des denylists en complément. Le billet ne détaille pas non plus le taux de rejet du filtre sémantique, ni la fréquence de réévaluation des seuils.
Enfin, ce cas s'appuie sur une infrastructure adtech déjà mature : volumes de requêtes massifs, équipes data dédiées, pipeline de diffusion publicitaire existant (Yahoo DSP). Une PME sans cette infrastructure ne peut pas reproduire l'architecture telle quelle : elle devra d'abord disposer d'un flux de requêtes suffisant pour justifier le coût d'inférence LLM par rapport à une solution plus simple.
Par où commencer si vous voulez transposer l'approche
Mesurez d'abord le taux d'échec de votre expansion actuelle : sur quelle proportion de requêtes votre système existant (mots-clés manuels, thésaurus, ancien modèle) ne retourne rien ou des résultats hors sujet. C'est ce segment qui justifie l'investissement dans un LLM.
Testez un prototype limité sur Amazon Bedrock ou un service équivalent, avec un seul modèle et un échantillon de quelques centaines de requêtes réelles, avant tout déploiement. Comparez le coût d'inférence par requête au gain de couverture observé.
Construisez le garde-fou avant le volume : un scoring de similarité par vecteurs sémantiques (via un service comme Amazon OpenSearch Service pour l'indexation vectorielle) et une denylist métier doivent exister dès le prototype, pas après le premier incident de ciblage.
L'architecture Yahoo illustre un principe transposable au-delà de l'adtech : un LLM génératif en production n'est acceptable que couplé à un mécanisme de vérification indépendant du modèle qui a produit la sortie. C'est ce couple génération plus vérification, pas le modèle seul, qui constitue l'apport réel de ce cas.
Sources
How Yahoo enhances search retargeting using Amazon Bedrock — AWS, AWS Machine Learning Blog, 18/06/2026
Amazon Bedrock — AWS, Amazon Web Services, 01/07/2026
Claude 3.5 Sonnet — Anthropic, Anthropic, 22/10/2024
Amazon OpenSearch Service — AWS, Amazon Web Services, 01/07/2026
Cet article a été rédigé et illustré par un système d'intelligence artificielle à partir des sources citées ci-dessus, puis publié automatiquement, sans relecture humaine préalable. Si vous relevez une erreur factuelle, merci de nous la signaler.


Comments